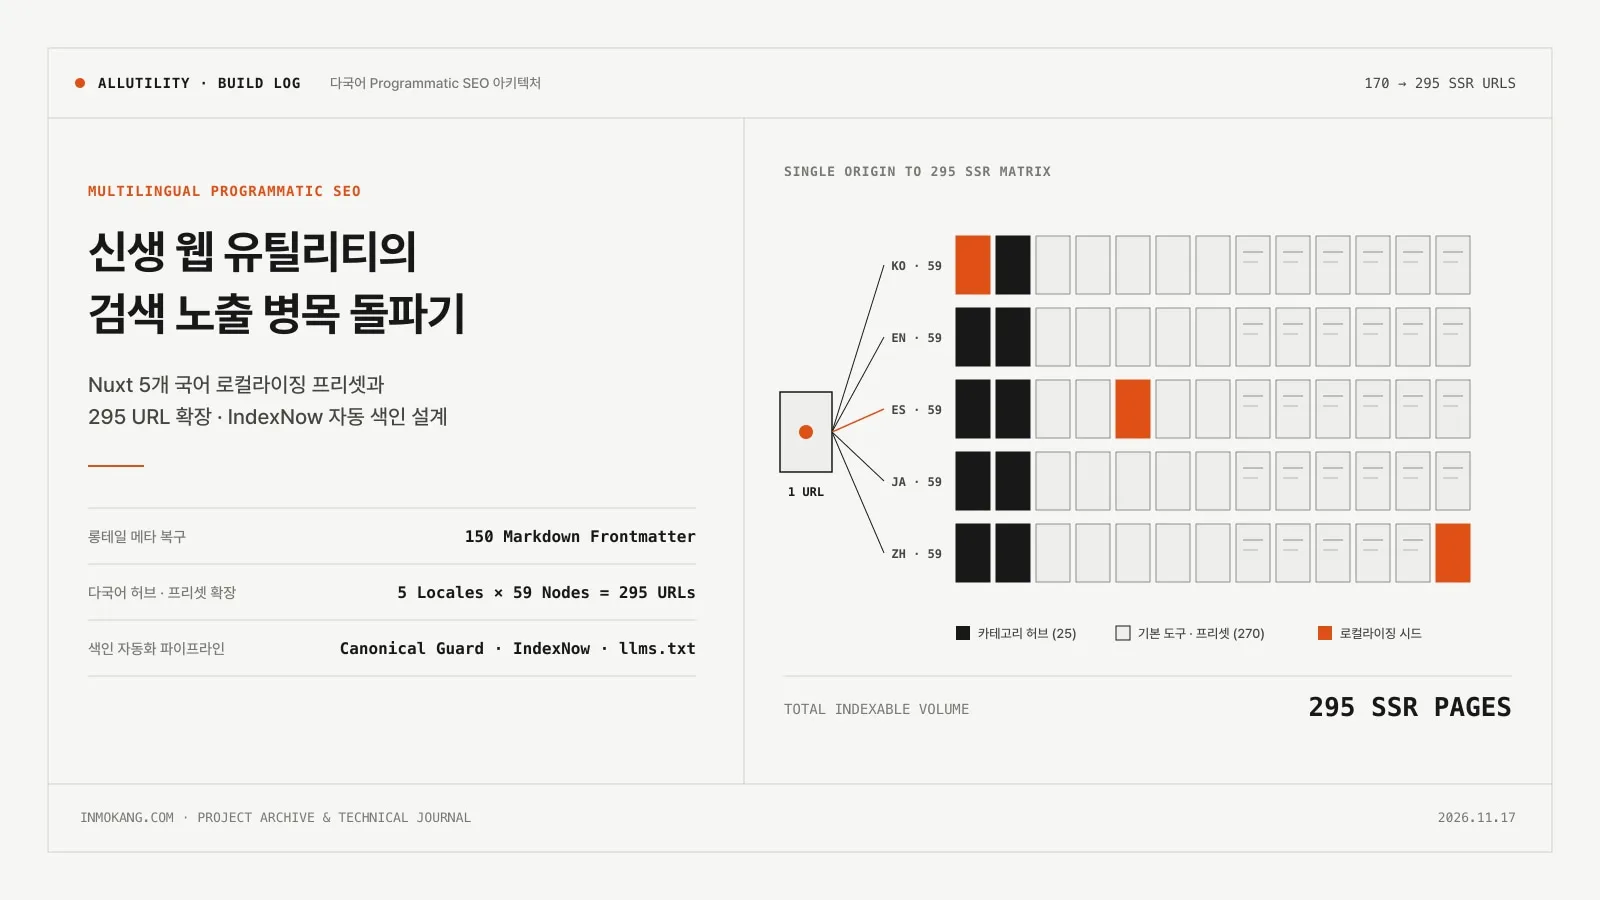
신생 웹 유틸리티의 검색 노출 병목 돌파기: Nuxt 5개 국어 Programmatic SEO와 295 URL 확장 아키텍처
서버로 데이터를 전송하지 않는 100% 브라우저 로컬 처리와 스위스 에디토리얼 미니멀리즘을 결합해 다국어 웹 도구 플랫폼 AllUtility를 구축했습니다. 한국어·영어·중국어·스페인어·일본어 5개 국어로 30종의 계산기와 개발·촬영 유틸리티를 배포했지만, 런칭 직후 마주한 현실은 냉정했죠.
GA4와 Google Search Console 데이터를 1일 단위로 뜯어본 결과, 표면적인 세션 증가 뒤에는 크롤러 봇의 착시가 숨어 있었고 Google 자연 검색 노출은 주간 한 자릿수에 묶여 있었습니다. 기능의 완성도만으로는 초기 도메인의 **'샌드박스 구간'**과 대형 포털이 선점한 단일 키워드 장벽을 넘을 수 없었던 것입니다.
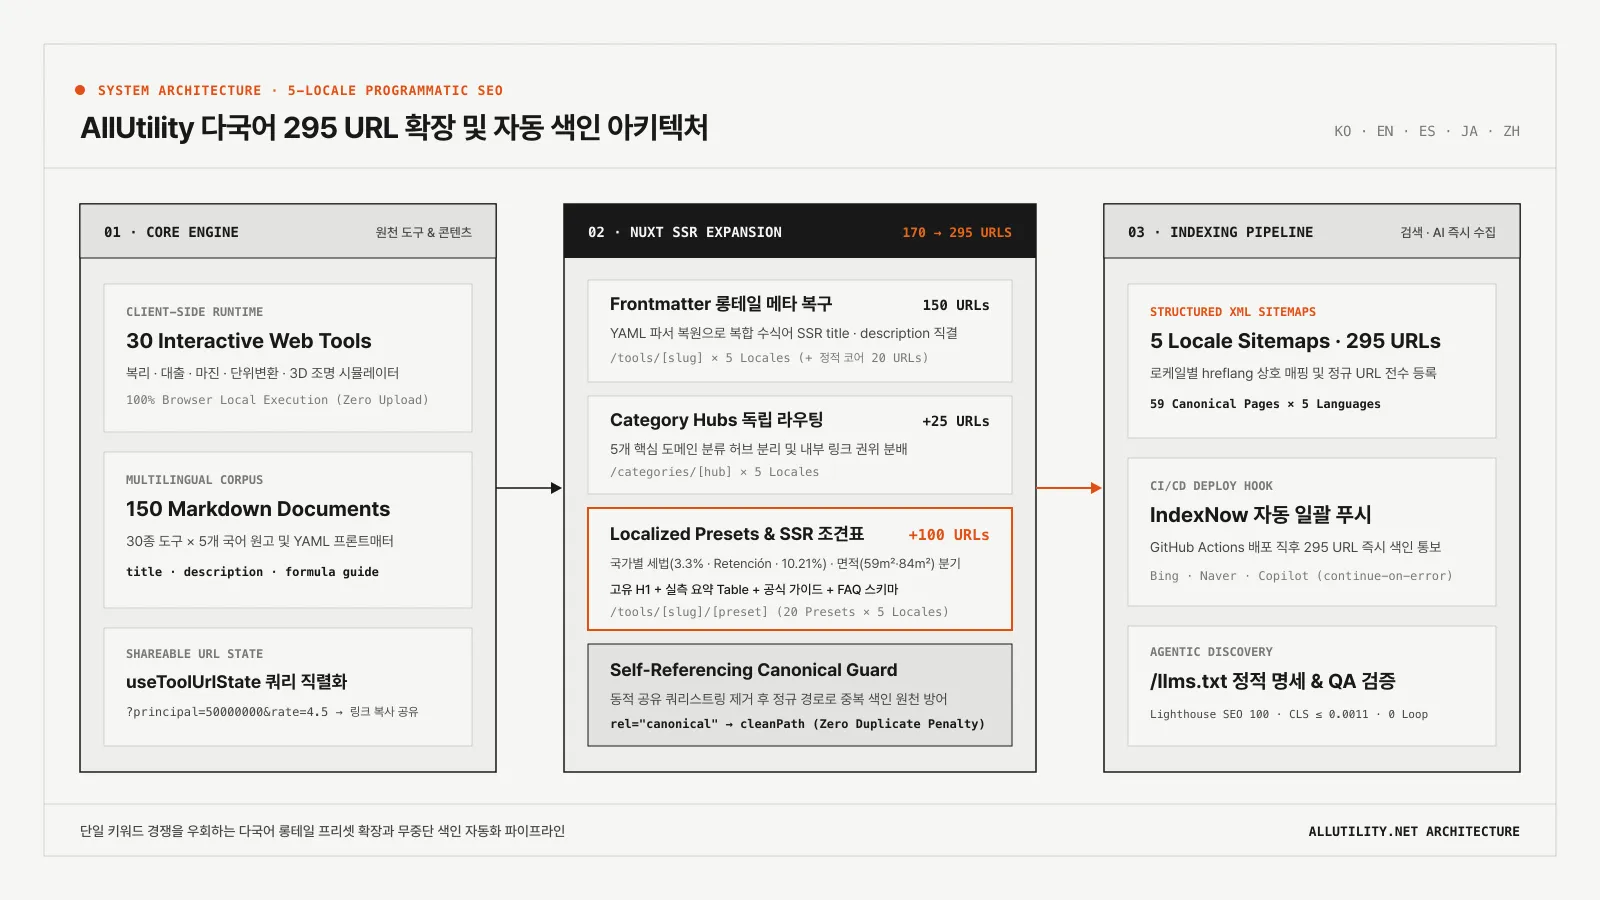
이 글에서는 코드베이스 전수 감사를 통해 찾아낸 프론트매터 유실 버그 복구부터, 국가별 세법 로컬라이징을 반영한 Programmatic SEO(170개 → 295개 URL 확장), 그리고 쿼리스트링 공유 루프와 IndexNow 자동 배포 파이프라인까지 구축하고 검증한 과정을 공유합니다.
1. 문제 진단: 트래픽 착시와 신생 도메인의 3가지 병목
배포 초기 일주일간 지표를 표면적으로만 보면 활성 사용자와 세션이 전주 대비 3배 가까이 늘어난 것처럼 보였습니다. 그러나 유입원과 체류 시간을 교차 분석하자 두 가지 뚜렷한 신호가 드러났습니다.
- 봇 트래픽 착시 분리: 특정일 해외 클라우드 데이터센터 거점(Direct)에서 유입된 세션 대다수는 체류 시간 1초 미만의 검증 크롤러였으며, 실제 인간 사용자의 참여 세션은 극소수에 불과했습니다.
- 예상 밖의 첫 글로벌 전환: 정작 의미 있는 실사용(
tool_execute이벤트 4일 연속 발생)은 Google이 아니라 Bing 스페인어 자연 검색(/es/tools/calculator)으로 유입된 남미 지역 사용자에게서 먼저 터져 나왔습니다.
왜 Google 자연 검색은 잠잠하고 Bing 다국어 페이지에서만 먼저 반응이 왔을까요? 실제 서버 API와 라우팅 구조를 대조해 보니 원인은 도구의 품질이 아니라 3가지 구조적 손실에 있었습니다.
| 병목 구간 | 기존 아키텍처 상태 | 검색엔진 관점의 문제점 |
|---|---|---|
| 메타 타겟팅 손실 | 마크다운 본문 로드 시 상단 YAML 프론트매터를 정규식으로 일괄 제거 | 공들여 작성한 150개 롱테일 타이틀이 버려지고 초경쟁 단일어(복리 계산기)만 출력 |
| 단일 URL 한계 | 1 도구 = 1 URL 구조 및 메인 페이지 내 탭 필터로만 카테고리 전환 | 84제곱미터 몇평, 3.3% 역산 등 구체적 상황별 롱테일 검색어 진입점 부재 |
| 확산·색인 루프 부재 | 계산 결과 상태 공유 URL 미지원 및 수동 색인 의존 | 사용자 자생 백링크 생성 불가, AI 검색(llms.txt) 및 IndexNow 즉시 반영 누락 |
2. Quick Win: 버려지던 150개 마크다운 롱테일 메타데이터 복구
가장 먼저 발견한 치명적인 누락은 서버 API의 마크다운 파서였습니다. 5개 국어 × 30개 도구(총 150개) 마크다운 파일 상단에는 이미 경쟁을 우회할 수 있는 정교한 롱테일 title과 description이 작성되어 있었죠.
하지만 서버 라우트에서 본문 HTML만 추출하기 위해 프론트매터 블록 전체를 빈 문자열로 치환하면서, 정작 클라이언트 페이지의 useSeoMeta에는 짧은 도구 이름만 전달되고 있었습니다.
// 수정 전: 프론트매터 메타데이터가 파싱 없이 그대로 삭제됨
const rawMarkdown = await fs.readFile(filePath, 'utf-8')
const bodyContent = rawMarkdown.replace(/^---\n[\s\S]*?\n---\n*/, '')

// 수정 후: title·description 프론트매터를 구조화해 SSR 메타로 직결
function parseFrontmatter(raw: string) {
  const match = raw.match(/^---\r?\n([\s\S]*?)\r?\n---\r?\n*/)
  if (!match) return { meta: {}, body: raw }

  const meta: Record<string, string> = {}
  for (const line of match[1].split(/\r?\n/)) {
    const idx = line.indexOf(':')
    if (idx > 0) {
      const key = line.slice(0, idx).trim()
      const val = line.slice(idx + 1).trim().replace(/^['"]|['"]$/g, '')
      meta[key] = val
    }
  }
  return { meta, body: raw.slice(match[0].length) }
}
이 파서 복구 작업 하나만으로 원고 한 줄 추가 작성 없이 150개 페이지 전체가 즉시 '초기 원금·월 적립식·세후 만기 수령액 시뮬레이터' 같은 복합 롱테일 키워드를 동시에 겨냥하게 되었습니다.
핵심 포인트: 신생 도메인이 대형 포털이나 금융권 사이트와
'복리 계산기','단위 변환기'같은 단일 헤드 키워드로 정면 승부하면 1페이지 진입이 불가능합니다. 코드에 잠자고 있던 구체적 수식어와 용례를<title>과meta description에 복원하는 것만으로도 유효 타겟 범위가 수배 넓어집니다.
3. Programmatic SEO 설계: 단순 번역이 아닌 로컬라이징 프리셋 확장
두 번째 단계는 유틸리티 사이트 성장의 핵심 공식인 **'Programmatic SEO'**를 도입하는 일이었습니다. 사용자는 추상적인 도구 이름보다 당장 해결해야 할 구체적인 수치와 맥락으로 검색하기 때문입니다.
3.1. Thin Content 판정을 피하는 적정 볼륨과 SSR 조견표
초기 도메인 상태에서 한 번에 수천 개의 파생 URL을 찍어내면 검색엔진이 이를 **'스팸성 얇은 페이지(Thin Content)'**로 분류해 크롤링 예산을 묶어버릴 위험이 큽니다. 따라서 1차 확장은 실수요가 검증된 **핵심 프리셋 20종 × 5개 국어(100 URL)**와 **카테고리 허브 5종 × 5개 국어(25 URL)**로 정밀하게 제한했습니다.
- 카테고리 허브 독립 라우팅: 탭 필터에 갇혀 있던 분류를 금융·비즈니스 정밀 계산기 허브 등 독립 URL로 분리해 중위 키워드 유입과 내부 링크 권위 전달 경로를 확보했습니다.
- SSR 전용 콘텐츠 보강: 모든 프리셋 URL(
/tools/[slug]/[preset])은 단순 초기 입력값만 바꾸는 데 그치지 않고, 서버 렌더링 시점에 고유<h1>, 실측 요약 조견표(<table>), 공식 해설 가이드, FAQ 스키마를 함께 내려주도록 구성했습니다. - 독점 니치 도구 자산화: 경쟁 도구가 거의 없는 3D 촬영 조명 도구는 3D 스튜디오 렘브란트 조명 시뮬레이터나 무영 촬영 세팅처럼 사진가가 바로 참고할 수 있는 표준 도해 프리셋으로 공개했습니다.
3.2. 국가별 세법 차이를 반영한 다국어 로컬라이징 매핑
다국어 Programmatic SEO에서 가장 흔히 저지르는 실수는 한국 고유 제도를 외국어로 직역해 검색 수요가 '0'인 죽은 URL을 양산하는 것입니다. 대표적으로 프리랜서 3.3% 원천징수 실수령액 및 세전 역산 계산기의 '3.3% 원천징수'는 한국 세법에만 존재하는 개념이죠.
이를 해결하기 위해 동일한 프리셋 슬러그(withholding-tax-reverse) 안에서도 로케일별로 현지 실검색 수요가 높은 세금 역산 시나리오로 데이터 페이로드를 분기했습니다.
| 로케일 | 타겟 프리셋 포지셔닝 | 현지 핵심 검색 맥락 |
|---|---|---|
한국어 (ko) | 프리랜서 3.3% 원천징수 & 세전 청구액 역산 | 세후 희망 수령액 기준 세전 계약 금액 Gross-Up 계산 |
영어 (en) | Freelance Withholding & Reverse Net-to-Gross | 프리랜서 원천징수율 커스텀 설정 및 세전 청구액 역산 |
스페인어 (es) | 스페인어 세금 역산(Gross-Up) 계산기 | 중남미·스페인 프리랜서 Retención 공제 및 Bruto 역산 |
일본어 (ja) | 源泉徴収 10.21% 手取り・逆算シミュレーター | 일본 프리랜서 원천징수세율(10.21%) 기준 실수령·청구액 계산 |
중국어 (zh) | 劳务报酬扣税与税前反推计算器 | 노무보수 세후 수령액 기준 세전 금액 역산 시뮬레이션 |
마찬가지로 부동산·인테리어 실수요가 높은 평 ↔ 제곱미터(㎡) 면적 환산 프리셋 역시 국민주택 규모인 59㎡·84㎡ 조견표를 SSR 테이블로 기본 탑재해 검색 직후 스크롤 없이 답을 얻도록 설계했습니다.
4. 바이럴 공유 루프와 AI·검색엔진 색인 파이프라인 구축
페이지를 확장한 뒤에는 사용자가 직접 링크를 퍼 나르는 자생적 백링크 구조와, 검색엔진 및 AI 에이전트가 변경 사항을 즉시 수집하는 자동화 파이프라인을 맞물려야 합니다.
4.1. 쿼리스트링 상태 공유와 Self-Referencing Canonical 방어
복리·대출·마진·단위변환·3D 조명 도구에 현재 입력값을 그대로 URL 쿼리(?principal=50000000&rate=4.5)로 직렬화하는 useToolUrlState 컴포저블과 [결과 링크 복사] 버튼을 추가했습니다. 사용자가 커뮤니티나 메신저에 계산 조건이 담긴 링크를 공유하면 자연스럽게 레퍼럴 유입이 발생합니다.
단, 쿼리 파라미터가 붙은 수만 개의 조합 URL이 검색엔진에 각각 색인되면 중복 문서 패널티를 받게 됩니다. 이를 막기 위해 루트 레이아웃에서 모든 쿼리스트링을 제거한 순수 정규 경로로 canonical 태그를 강제 고정했습니다.
// app.vue: 쿼리 파라미터가 붙은 공유 URL도 항상 순수 정규 경로로 canonical 고정
const route = useRoute()
const siteUrl = 'https://allutility.net'

const cleanCanonical = computed(() => {
  const cleanPath = route.path === '/' ? '' : route.path.replace(/\/+$/, '')
  return `${siteUrl}${cleanPath || '/'}`
})

useHead(() => ({
  link: [{ rel: 'canonical', href: cleanCanonical.value }]
}))
4.2. llms.txt 제공 및 GitHub Actions 배포 시 IndexNow 자동 통보
초기 실사용 유입이 Bing에서 먼저 발생했다는 점에 주목해, Bing 및 AI 검색(ChatGPT Search, Copilot, Perplexity) 인덱싱 파이프라인을 코드 레벨에서 자동화했습니다.
/llms.txt정적 명세서 배포: 30종 도구와 주요 프리셋의 입출력 역할 및 정규 URL 구조를 마크다운 표준 포맷으로 정리해 LLM 크롤러의 도구 인용 확률을 높였습니다.- 무중단
IndexNow배포 훅: 배포 워크플로우의 운영 컨테이너 교체 직후 5개 로케일 295개 전체 URL을IndexNowAPI로 즉시 전송하되, 외부 API 일시 장애가 배포 자체를 중단시키지 않도록continue-on-error: true가드를 적용했습니다.
트러블슈팅 인사이트: 배포 전 로컬 헤드리스 브라우저와 라이브 스모크 스크립트로 295개 전체 URL을 전수 검사한 결과, 후행 슬래시 리다이렉트 루프 0건, Lighthouse SEO 100점,
CLS 0.0011이하, 그리고 신규 원천징수 탭 실행 시 GA4tool_execute이벤트 적재까지 오차 없이 통과하는 것을 확인했습니다.
마무리하며: 유틸리티 서비스의 초기 샌드박스 돌파 공식
신생 도메인으로 유틸리티 서비스를 운영할 때 검색 노출을 앞당기는 핵심 실무 포인트를 요약하면 다음과 같습니다.
- 잠자고 있는 롱테일 메타데이터 점검: 마크다운이나 데이터 파일에 작성된 구체적 키워드가 실제 SSR
<title>과description까지 유실 없이 도달하는지 먼저 확인해야 합니다. - 번역이 아닌 현지 맥락 기반 Programmatic SEO: 단순 직역 페이지 대량 생성 대신, 국가별 세법·단위 습관에 맞춘 프리셋과 SSR 조견표(
<table>)로 검색 의도를 정면 충족해야 Thin Content 판정을 피할 수 있습니다. - 공유 쿼리스트링과 Canonical의 분리 설계: 사용자에게는 상태가 보존된 동적 쿼리 URL을 제공하고, 검색엔진에는 쿼리가 제거된 정규 경로
canonical만 노출해 바이럴 확산과 색인 깔끔함을 동시에 잡으시길 바랍니다. - 배포 파이프라인과 색인 핑의 일체화: 사이트맵 확장(
295 URL),/llms.txt, 그리고 CI/CD 기반IndexNow자동 제출을 묶어두면 기능을 추가할 때마다 검색엔진 반영 시차를 최소화할 수 있습니다.